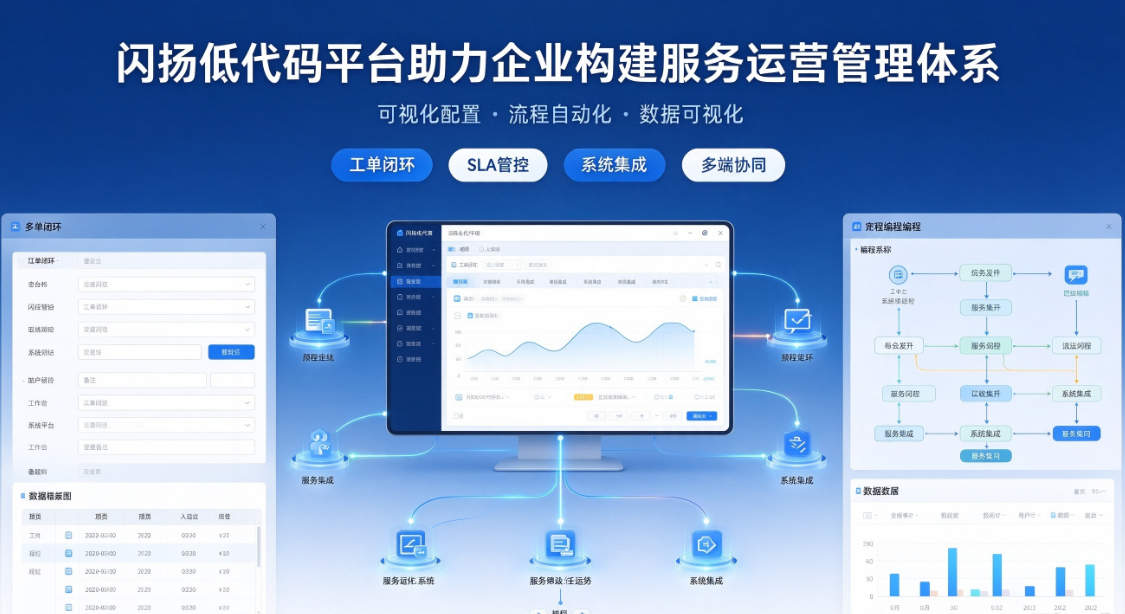
企业上线服务管理系统后,最常见的返工往往不是界面不好看,而是流程一变就要改代码。服务目录会扩充,组织与岗位会调整,响应与解决时限会按服务级别重新约定——把流程“写死”在代码里,意味着每一次业务调整都要经历排期、开发、回归测试。我们在设计 ITSMTOP 信息流管理平台时,把“流程可被配置”作为前提,而不是附加功能。本文从设计资料中整理四个关键设计点。
图 1:服务流程与信息流配置示意(来源:闪扬科技推广资料)
一、流程先有“类型”和“版本”,才谈得上复用
一个可配置的流程,首先不是一个页面或一张图,而是一组可版本化的配置对象。设计文档中把流程类型定义为事件、问题、变更、任务等,并对流程图提供导出、修改、删除的版本管理能力;字段支持导出、导入与主键定位查询;流程还需要与页面绑定、与数据源绑定。
这样做的意义在于:同一类服务请求可以沿用同一套流程骨架,只在版本上做差异;当服务条目调整时,改动落在配置层,而不是重新开发一套表单与接口。服务条目本身也被建模——名称、流程版本、服务级别、运营时间、图标、描述、二维码都是可维护的字段;服务包则负责服务包定义以及流程访问权限的授权。
二、派单不是“指定一个人”
流程流转分为手动与自动两类。手动流转支持指定多个组、可指定多个人,并给出默认组定义;自动流转支持按业务分类派发、按固定角色派发,或直接指定组与人。
更关键的是分派条件的表达方式。条件可以使用人员的固定属性(部门、角色),也可以使用自定义字段(职能组、技能组等),支持多条件组合、and/or 逻辑,以及精确匹配与模糊匹配。分派按“组—人”依次确定,组为必选、人可选,不指定人时工单落到组;一张工单可以通知多个人,谁受理谁处理。这套规则把“谁来处理”从硬编码判断,变成一张可维护的条件表。流程环节还可与通知关联,通知人和通知内容同样可定义。
三、页面、字段与审批规则同样要可配
配置的颗粒度需要下沉到页面。字段定义包含名称、类型、长度与默认值,另有数据块、行列与表格定义;默认值支持当前时间、登录人电话、邮箱、所在机构、当前 IP 等变量。规则层提供用户显隐(显示、隐藏、无权限)、动作显隐(只读、隐藏、非空)、级联、字段规则校验、友情提示与日志记录,审批规则支持一票制与全票制。
统计口径也在设计阶段就预留:通过标签定义 key,用于标记处理人、关闭人、转单、已解决等节点;流程备注会进入流程日志。换句话说,后续报表所依赖的数据,不是事后补采的,而是流程运行时就结构化留下的。
四、SLA 计时必须绑定到路径,而不是“环节开始/结束”
服务级别管理最容易出错的地方,是计时规则过于简化。设计资料中把场景拆开讨论:用户提报及信息收集、确认阶段属于信息完备过程,SLA 不计时;服务台受理时响应计时开始,若当场解决则计时结束,若升级二线则计时不应停止;用户确认后系统关闭工单,用户未确认则由系统在指定时间后关闭;工单被打回重新处理时,SLA 需要支持累计计时或重新计时。
由此可见,把“起止”简单挂在环节的进入或离开事件上并不成立——同一个环节存在多条出口路径,只有其中一条应当停止计时。可行做法是把计时动作绑定到具体路径(按钮)上,并在路径上定义处理开始时间与处理结束时间。
五、可配置能力需要一个分层的底座
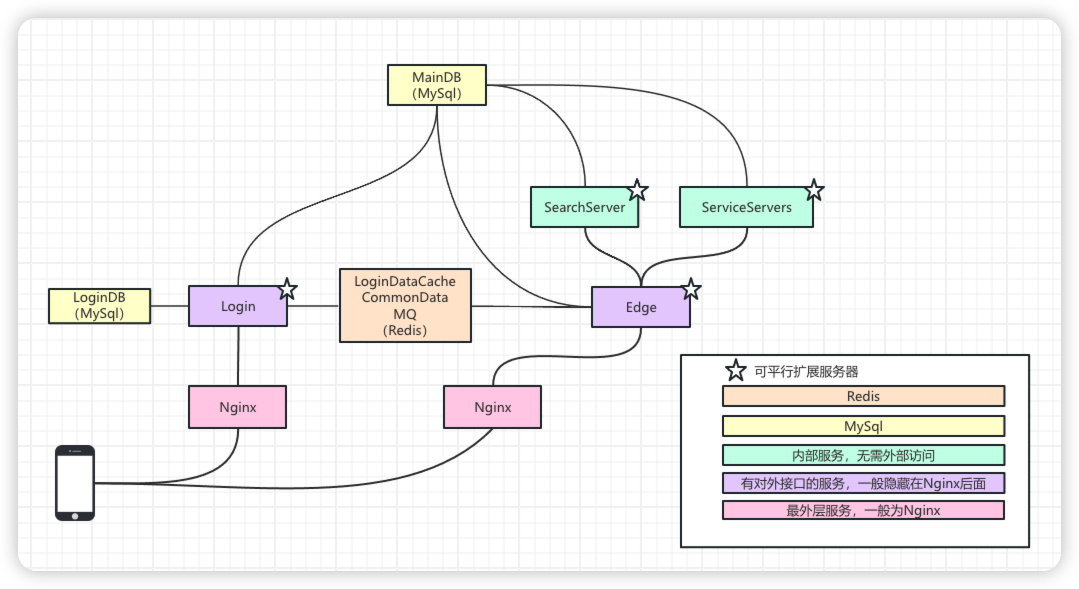
图 2:平台分层架构设计示意(来源:闪扬科技信息流管理平台设计资料)
配置化不是把所有逻辑堆在一个应用里。架构设计采用分层思路:最外层由 Nginx 承接接入,登录与登录数据缓存独立,主数据落在 MySQL,缓存与消息使用 Redis/MQ,边缘服务(Edge)连接搜索服务与业务服务;对外的接口一般隐藏在 Nginx 之后,内部服务无需暴露到外部,各层可按需要平行扩展。设计阶段也对表单引擎、流程引擎、工作流引擎、权限框架、文件服务与预览方案分别做过选型评估。
这种分层让“配置”与“执行”分离:配置层负责定义流程、页面、规则与计时,执行层负责按定义流转并记录日志。业务调整时,变化的只是配置数据。
写在最后:三点落地建议
先梳理服务目录,再画流程图。明确服务条目、服务级别与流程类型,流程才有可复用的骨架。
把派单规则写成条件表。用部门、角色、职能组等属性表达“谁来处理”,避免代码中堆砌判断分支。
把 SLA 起止定义到路径上。区分响应与解决、正常关闭与超时关闭、首次处理与打回重开,避免计时口径失真。
配置化不会消除业务梳理的工作量,但它能让梳理结果直接落到系统里,并且在下一次组织调整时仍然可用。