
在二十世纪六十年代,服务品质协议(service-level agreement)(SLA)是用于达到已定义的服务品质和响应服务问题的一般操作程序,而这些服务问题是用户组织在购买或租用大型机上的机器时间时就已经同意过的。 超大型计算机(big iron)是缺省的企业系统,其它任何技术的处理能力都无法与它相比。当客户机的服务器和网络桌面系统进入计算机世界时,人们就构思出了分布式网络系统这个概念。这些系统后来发展成了跨网络运行企业资源规划(ERP),供应链管理(SCM)和客户关系管理(CRM)系统的企业范围的系统。
在这个发展过程中,企业对因特网的依赖已经使得公司的应用程序套件的网络延迟影响越来越明显。同时,用户已经委托一定品质的服务质量保证相关的可用性、可靠性和响应时间以确保业务运转不被中断,并且依赖外部服务提供者来提供应用程序、因特网、网络,受管服务和其它服务。结果,SLA变得更复杂,范围更广,一个用户可以有与不同提供者签定的几个SLA。反过来,提供者自己的SLA也可以是与其它提供者签定的,每个SLA都有一套不同的需求、衡量标准和例外情况。
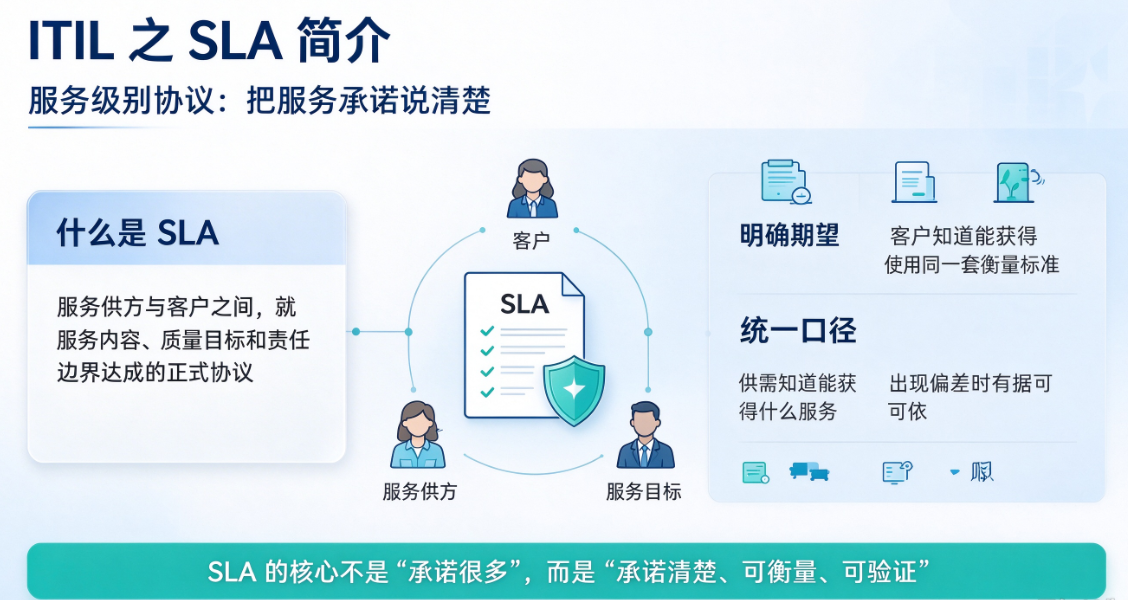
SLA是服务提供者和客户之间的一个正式合同,用来保证可计量的网络性能达到所定义的品质。SLA为服务提供者提供了一种在当今多变而又竞争激烈的市场中胜过对手的方法。服务提供者可能是一个国内的IT组织、一个应用程序服务提供者(ASP)、一个网络服务提供者(NSP)、一个因特网服务提供者(ISP)、一个受管服务提供者(MSP)或者任何其它类型的服务提供者。
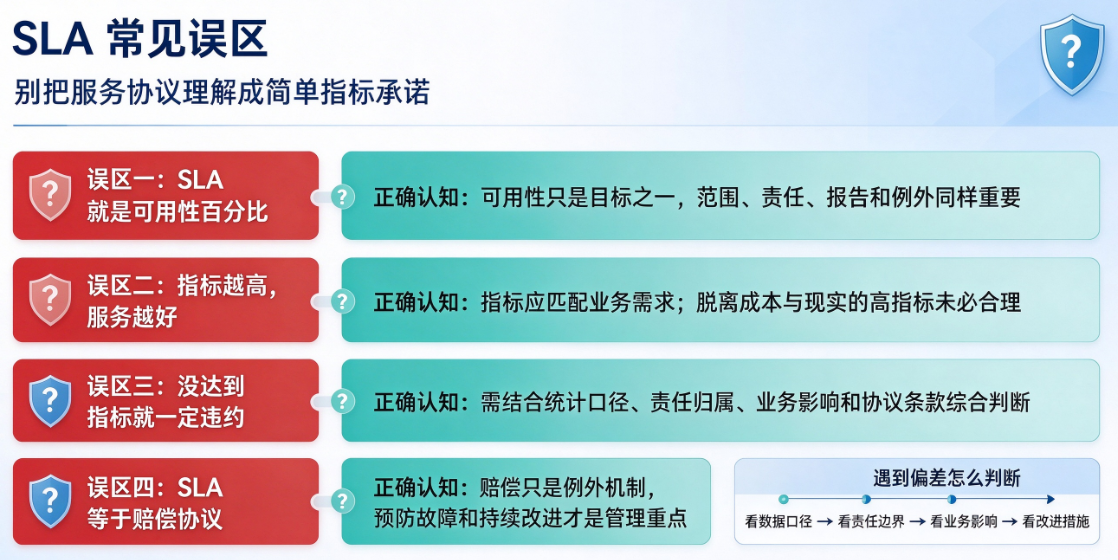
SLA可以非常笼统或者极度详细,它一般都包含出现故障时服务提供者和客户应采取的步骤。服务提供者保证它提供的服务在一定百分比的时间内(例如,99.9%)是可用的。提供者还能够强制向客户通知SLA当机时间的最长和平均响应时间,或者在网络接口发生改变之前的最长和平均响应时间,并利用基于因特网的工作流自动化、分发和报告技术。如果经过指定的一段时期后提供者无法达到所定义的性能品质,客户就可以获得一些权利和赔偿。各个SLA的权利、赔偿和例外情况是不同的。客户还同意接受协议一般条款的指定例外情况。
在每个SLA中都必须精确定义服务品质;否则各方关于SLA将以哪种品质衡量什么服务或性能标准将无法达成一致。例如,一个客户可能认为一个双方同意的服务品质将衡量网络A、网络B和网络C,同时后两者连接到第一个,而服务提供者却认为它只衡量网络A。还有一点很重要的是正常运行时间可用性百分比的小数位数:例如,一年中的当机小时数和当机天数比,99.999%的正常运行时间所允许的当机时间比99.9%的正常运行时间所允许的当机时间还少。SLA应该为客户包含进一个退出条款;当因为不能圆满解决经常发生的可用性、可靠性和安全性问题而使客户的业务运转频繁中断时,客户希望他有终止协议的权利。
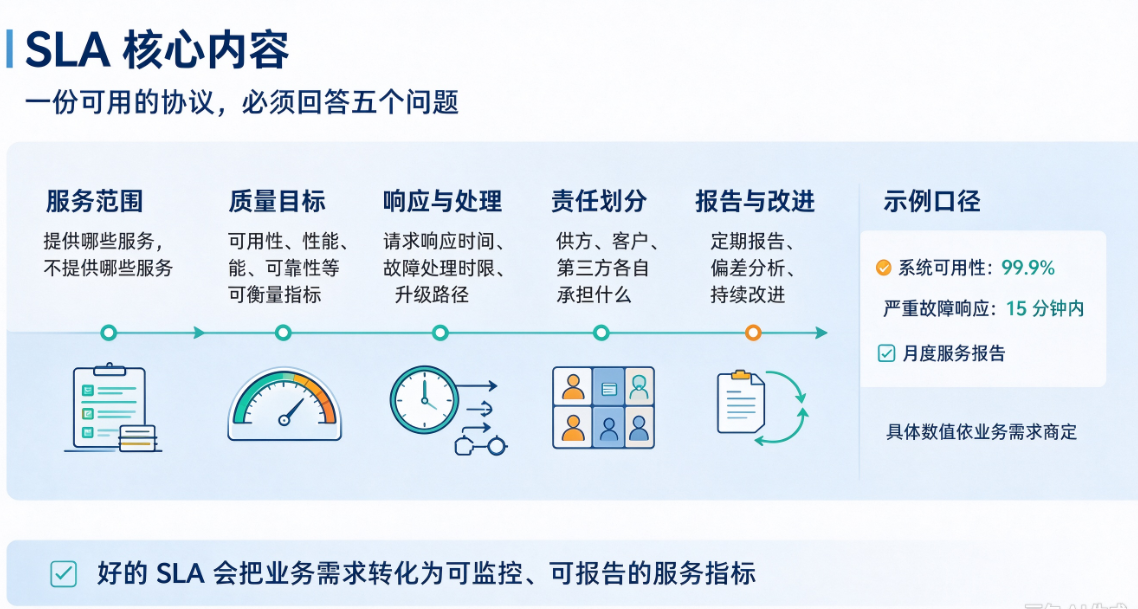
像任何协议或保险单一样,SLA通常会指定其条款中的例外情况。IT服务的SLA应该包含关于例外情况的详细信息。我将随意将它们分为四类:故障、不受服务提供者直接控制的问题、拒绝服务和预订的维护。只要客户公司可以得到当机期间的适当赔偿,还可以添加其它一些例外情况来适应提供者的情况。通过在SLA中包含进例外情况,提供者可以在出现问题或网络损耗时免负责任。另一方面,如果竞争的服务提供带有极少例外情况的SLA,客户可以选择那些在业务运转中提供更长正常运行时间并且有更好的服务保障的协议。即使99.5%、99.9%和99.999%这几个正常运行时间可用性保证之间的差别也可以影响选择SLA的决策者。
我们去细化SLA,去定义SLA,写明例外情况,如同去餐馆吃饭享受到的服务一样,我们正是通过SLA去购买有保障的IT服务。对甲方而言,SLA可以降低风险,明确厂商、服务提供商、供应商要承担的责任;对乙方而言,SLA是对甲方的承诺,按照SLA菜单提供相应的有偿服务,确保服务持续有效。风险是不确定的,而SLA是去消除不确定的风险,机房的UPS电源、空调、服务器和网络设备,都要有维保合同,厂商提供5*7或是7*24服务,正是由于SLA合同的执行来确保服务的品质。用户的期望值从SLA得出的,SLA承诺提供KFC汉堡,最后供应的是必胜客披萨,那么用户的期望值大大满足,反之,给用户的是麦当劳的猪柳蛋汉堡,用户感觉吃亏了,对服务多半不满意。我们给用户提供SLA的同时,传达给用户SLA能够达到什么样的级别,让用户能够清楚付费的SLA价值多少,3个9和5个9服务支持差别很大,最终达成双赢。
-----------
成功 SLA 的一些关键要求包括:
它们必须与服务目录中定义的“服务”相关;否则它们只是没有目的的单个指标,不能提供足够的可见性或反映服务的观点。
它们应与确定的结果相关,而不仅仅是运营的指标。这可以通过平衡的指标组合来实现例如客户满意度和关键业务结果。
它们应反映“协议”,即服务提供者和服务消费者之间的契动和讨论。让所有的利益相关者都参与进来是非常重要的,包括合作伙伴、赞助人、用户和客户。书写必须简单,便于各方理解和使用。
------------------
西瓜 SLA 效应:
传统 SLA 基于单独活动,例如事件解决时间、系统可用性('99.9')和容量指标(例如,事件或请求处理的数量)。如果没有业务环境,这些指标通常毫无意义。例如,虽然系统可用性99.6%令人印象深刻,但这仍然需要与关键业务要求保持一致。系统可能有一个可接受的不可用的 0.4%,但如果在发生重要流程(例如商业交易,使用中的手术室或使用中的销售终端)时,则无论是否满足 SLA,客户/用户满意度都将很低。
如果服务提供者认为自己做得很好(报告都是绿色的),而实际上客户对收到的服务不满意并且对提供者没有注意到这一点感到沮丧,那么对于服务提供者来说这可能是个问题。这就是所谓的西瓜 SLA 效应,因为像西瓜一样,SLA 可能在外面看起来是绿色的,但实际上里面是红色的。
------------------
某集团SLA制度参考
服务时间定义:工作日 8:30–18:00;非工作时段仅受理特级、一级故障应急处置;二级、三级故障及普通服务请求非工作时间顺延至下一个工作日服务时段开始计算 SLA 时长。 计时口径:工单成功提交并录入 ITSM 系统的时间为 SLA 计时起点;工单完成处置、业务恢复并经用户确认,工单闭环时间为计时终点。 升级规则:达到升级阈值未取得有效进展,必须触发升级,同步业务负责人与运维管理层。
| 事件等级 | 判定简述 | 首次响应时限 | 目标恢复 / 解决时限 | 升级触发规则 | 备注 |
|---|---|---|---|---|---|
| 特级故障(灾难性) | 集团全域核心业务中断、骨干网络瘫痪、存在重大数据丢失风险,影响集团全部经营活动 | 5 分钟内响应,主动联系业务负责人 | 2 小时内核心业务恢复;4 小时内彻底闭环 | 超过 10 分钟未响应,立即升级 IT 运维负责人、信息化分管领导 | 7×24 小时应急,全量资源投入,同步集团管理层 |
| 一级故障(严重) | 单一核心业务系统中断、多家子公司批量用户无法办公,不影响集团全域,但严重阻碍经营业务 | 10 分钟内响应介入 | 4 小时内业务恢复;8 小时内彻底闭环 | 超过 30 分钟无有效处置进展,升级运维主管 | 7×24 小时应急,持续向业务侧同步进展 |
| 二级故障(一般) | 单部门 / 小范围用户系统或功能异常,核心业务不受影响,仅局部办公受阻 | 20 分钟内响应介入 | 24 小时内闭环解决 | 超过 2 小时无进展,升级对应运维模块负责人 | 仅工作日服务时段计时 |
| 三级故障(轻微) | 单用户终端、单机软件、外设故障,仅影响单人办公,无业务系统层面影响 | 30 分钟内响应介入 | 48 小时内闭环解决 | 不设置自动升级,超时工单统一纳入月度 SLA 考核 | 仅工作日服务时段计时 |
| 普通服务请求(非故障类) | 账号开通 / 权限变更、软件安装、设备申领、技术咨询、配置调整等 | 1 小时内响应并确认需求 | 常规需求 24 小时内完成;复杂需求 48 小时内闭环 | 复杂需求须提前与业务用户约定交付周期,做好书面记录 | 仅工作日服务时段计时;变更类需求须遵守变更管控流程 |
配套量化统计指标(纳入 SLA 考核)
工单首次响应达标率:≥98%
工单按时闭环达标率:特级、一级故障≥99%;二级故障≥95%;三级故障≥90%;普通服务请求≥92%
故障恢复后复发率(同一问题 30 天内重复报修):≤2%
超时工单同步率:所有超时工单必须按时向业务用户同步进展,同步率100%
升级触发合规率:达到升级阈值必须执行升级,升级漏报率0%
计时免责说明
因用户原因(用户不在现场、无法提供必要信息、未配合操作)造成的处置延时,暂停 SLA 计时,需在工单内留存记录;
已报备审批的计划性维护停机时间,不计入 SLA 故障时长统计;
免责事项须在 ITSM 工单中上传佐证材料,经运维主管审核确认后方可生效。